@startuml

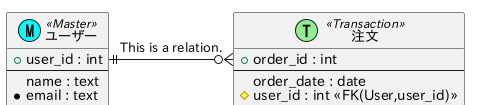
' 主キーuser_idと、nameとユニークなemailを持つ「ユーザー」テーブルを定義し、UserというPlantUMLで使う名前をつける
entity "ユーザー" as User {
  + user_id : int
  --
  name : text
  *email : text
}

' Userの表示をカスタマイズして、マスターだとはっきりわかるようにする
User << (M, cyan) Master >>

' 主キーorder_idとorder_dateと外部キーのuser_idを持つ「注文」テーブルを定義し、Orderという名前をつける
entity "注文" as Order {
  + order_id : int
  --
  order_date : date
  # user_id : int <<FK(User,user_id)>>
}

' Orderの表示をカスタマイズして、トランザクションだとはっきりわかるようにする
Order << (T, lightgreen) Transaction >>

' removeの説明用エンティティ
entity "無用" as Useless {
  + trash_id : int
}

@enduml
@startuml example_ER
/' entities.pumlを読み込む includeだと何回も読み込んで展開できる'/
!include_once entities.puml
/' 不要なエンティティーが描画されないように削除 '/
remove Useless
/'(E)や(C)といった目印文字を表示する表示しない場合は hide circle'/
show circle
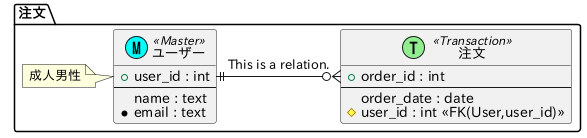
/' UserとOrderの関係を1対0以上で右並びで表示し、リレーションの線の上に注釈を書く'/
User ||--r--o{ Order : This is a relation.
@enduml
DGP <-function(N =10,T=10){
u <-matrix(rnorm(N*T, sd =1), N,T)
w <- u
rho <-0.5for(j in2:T){
w[, j]<- rho*w[, j -1]+ u[, j]}
beta <-c(0,-1,2)
mu <-rep(seq(0,100, length.out = N),T)
t <-rep(1:T, each = N)
i <-rep(1:N,T)
X <-cbind(1,matrix(runif(N*T*(length(beta)-1)), N*T,length(beta)-1))
y <- mu + X %*% beta +c(w)
df <-data.frame(y, X[,-1],as.factor(i),as.factor(t))colnames(df)<-c("y","x","z","i","t")
df
}set.seed(1023)
df01 <-DGP(20,10)head(df01,3)
           y         x         z i t
1 -0.5524994 0.3613191 0.2426655 1 1
2  7.0878804 0.9227929 0.5528946 2 1
3 10.6797476 0.7026300 0.5465261 3 1
# Paris-Winsten変換
y <-with(df01, y[lhs]- rho_hat*y[rhs])
x <-with(df01, x[lhs]- rho_hat*x[rhs])
z <-with(df01, z[lhs]- rho_hat*z[rhs])# lmコマンドを使う都合で、ダミー変数(と切片項の1)はParis-Winsten変換せず、推定に使う時点の観測値をそのまま使う
i <-with(df01, i[lhs])
t <-with(df01, t[lhs])# 差分モデルで推定
r_lm03 <-lm(y ~ x + z + i + t)coef(summary(r_lm03))[1:3,]
              Estimate Std. Error    t value     Pr(>|t|)
(Intercept)  0.2182374  0.3830573  0.5697253 5.697163e-01
x           -0.7630830  0.2382007 -3.2035302 1.658259e-03
z            1.9556396  0.2256916  8.6650984 6.714954e-15
の推定ですが、Baltagi and Li (1997)で以下の小標本のシミュレーションでより効率のよい手法が提案されています。
Q <-function(s, r_lm){
df <- r_lm01$model
N <-length(levels(df$i))T<-length(levels(df$t))
u <-residuals(r_lm)
r <-0for(t in(s +1):T){
t0 <- t - s
r <- r +sum(u[df$t == t]* u[df$t == t0])}
r /(N*(T- s))}
rho_hat_by_Q <-function(r_lm)(Q(1, r_lm)-Q(2, r_lm))/(Q(0, r_lm)-Q(1, r_lm))(rho_hat <-rho_hat_by_Q(r_lm01))
[1] 0.5679262
DGPの係数は0.5なので、確かにこちらの方がパフォーマンスが良いです。これを使った推定をすると、
              Estimate Std. Error    t value     Pr(>|t|)
(Intercept)  0.2140068  0.3794652  0.5639695 5.736171e-01
x           -0.7967706  0.2212629 -3.6010139 4.302451e-04
z            1.9605123  0.2098229  9.3436523 1.214826e-16
となります。こちらも微妙に改善されました。
*1:Baltagi (2005) "Econometric Analysis of Panel Data"
のpp.84–86にもあります