題名そのままなんですが、アンケート調査結果によくあるざっくり頻度(e.g. まったくない/たまにある/よくある/常にある)の比率をあらわす棒グラフからの順序ロジット回帰を行いたいと思います。
「多様な選択を可能にする学びに関する調査報告書」の図表21を見てみましょう。何かの傾向はありそうですが、すぐに分かるものではないです。
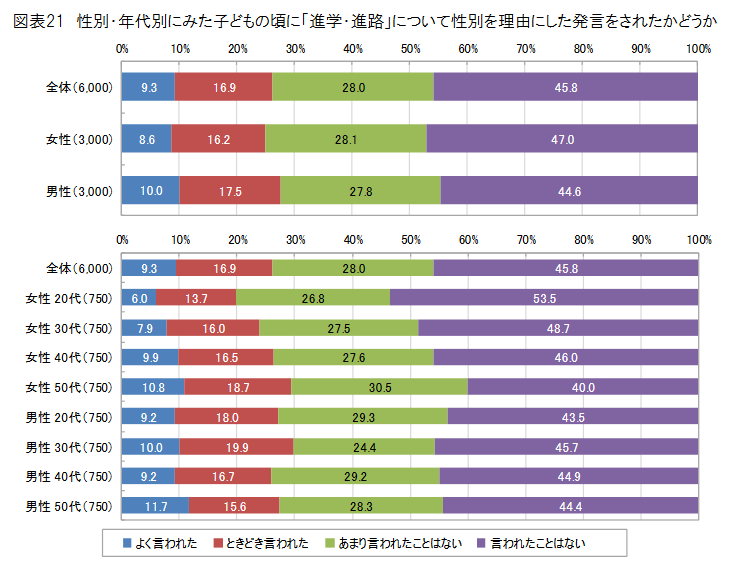
クロス表にして独立性検定をかけるのもひとつの方法ですが、独立性検定はどのような傾向があるのかは教えてくれません。異常値と言えるセルは分かるといえば分かるわけですが、回答項目に順序があるという情報を使ってくれません。
こういうときは順序ロジット回帰をかけてしまうと、話が分かりやすくなります。実際にやってみましょう。
頻度表の作成
図表21は比率が出ていると同時に、性別・年代ごとの合計数750も出ているので、比率を頻度表に戻すことができます。
# 比率を入力
P <- matrix(c(
6.0, 13.7, 26.8, 53.5,
7.9, 16.0, 27.5, 48.7,
9.9, 16.5, 27.6, 46.0,
10.8, 18.7, 30.5, 40.0,
9.2, 18.0, 29.3, 43.5,
10.0, 19.9, 24.4, 45.7,
9.2, 16.7, 29.2, 44.9,
11.7, 15.6, 28.3, 44.4
), 8, 4, byrow = TRUE)/100
# 使いまわしを考えて各行(i.e. 性別×世代)ごとにサンプルサイズを与える
nobs <- c(750, 750, 750, 750, 750, 750, 750, 750)
(N <- round(rep(nobs, ncol(P))*P))
     [,1] [,2] [,3] [,4]
[1,]   45  103  201  401
[2,]   59  120  206  365
[3,]   74  124  207  345
[4,]   81  140  229  300
[5,]   69  135  220  326
[6,]   75  149  183  343
[7,]   69  125  219  337
[8,]   88  117  212  333
頻度表からデータフレームの作成
尤度関数を自分で書く場合は頻度表をそのまま計算した方が速いのですが、表示のことを考えて集計前のデータフレームを再構成します。
ans <- integer(sum(N))
sex <- integer(length(ans))
gen <- integer(length(ans))
p <- 1
for(i in 1:nrow(N)){
   for(j in 1:ncol(N)){
      k <- j + (i - 1)*ncol(N)
      n <- N[i, j]
      q <- p + n - 1
      ans[p:q] <- j
      # 4行目までが女性、5行目からは男性の頻度
      sex[p:q] <- ifelse(i<=4, 1, 2)
      gen[p:q] <- i - 4*(4<i)
      p <- q + 1
   }
}
# ansは順序型,sexとgenは因子型にする
# ansは順序を1>2>3>4と値と逆順にしたあとラベリング
df01 <- data.frame(
   ans = ordered(ans, levels = 4:1, labels = c("never", "rarely", "sometimes", "frequently")),
   sex = factor(sex, labels = c("female", "male")),
   gen = factor(gen, labels = c("20s", "30s", "40s", "50s")))
順序型と因子型を使ったので、summaryがそれっぽくなっています。
summary(df01)
         ans           sex        gen
 never     :2750   female:3000   20s:1500
 rarely    :1677   male  :3000   30s:1500
 sometimes :1013                 40s:1500
 frequently: 560                 50s:1500
計算間違いがないか、データフレームを集計して頻度表とつき合わせておきましょう。
xtabs(~ gen + ans, df01, subset = sex == "female")
     ans
gen   never rarely sometimes frequently
  20s   401    201       103         45
  30s   365    206       120         59
  40s   345    207       124         74
  50s   300    229       140         81
xtabs(~ gen + ans, df01, subset = sex == "male")
     ans
gen   never rarely sometimes frequently
  20s   326    220       135         69
  30s   343    183       149         75
  40s   337    219       125         69
  50s   333    212       117         88
行列Nと比較して差異はないようです。
順序ロジット回帰
今回はMASS::polrで推定します。
library(MASS)
summary(r_polr <- polr(ans ~ sex*gen, df01, Hess = TRUE))
Call:
polr(formula = ans ~ sex * gen, data = df01, Hess = TRUE)

Coefficients:
                 Value Std. Error t value
sexmale         0.4013    0.09636   4.165
gen30s          0.2070    0.09719   2.130
gen40s          0.3320    0.09697   3.424
gen50s          0.5341    0.09601   5.563
sexmale:gen30s -0.2136    0.13621  -1.568
sexmale:gen40s -0.3887    0.13564  -2.866
sexmale:gen50s -0.5312    0.13517  -3.930

Intercepts:
                     Value   Std. Error t value
never|rarely          0.1591  0.0697     2.2826
rarely|sometimes      1.3668  0.0719    18.9988
sometimes|frequently  2.6093  0.0798    32.7184

Residual Deviance: 14787.40
AIC: 14807.40
できました。
- 男性ダミー(sexmale)の係数が正で大きいので、男性の方が性別を理由に進路について何か言われがちな
- 年代ダミー(gen*0s)が係数が正で、高い年齢ほど性別を理由に進路について何か言われたことが分かり、また男性ダミーと年代ダミーの交差項(sexmale:gen*0s)がそれを相殺するような大きさなので、高齢女性は男性と同じぐらい性別を理由に進路について何か言われがちだったが、時代とともに言われなくなり、今の若い女性は男性と比較してそういうことを言われない
ことが分かります。
ワルド検定
検定をしたら、男性も世代によって女性ほどではないが変化があるかも知れないと心配な人は、Wald検定でもかけましょう。
# 推定した係数(polrオブジェクトの場合、切片項はcoefでとれない)
b <- c(coef(r_polr), r_polr$zeta)
# 帰無仮説: gen50sの係数 + sexamle:gen50sの係数 = 0 を検定する
c_r <- grep("gen50s", names(b)) # gen50sが含まれる変数の列の位置
C <- rep(0, length(b)) # gen50sが含まれない変数の位置は0
C[c_r] <- 1 # gen50sが含まれる変数の位置は1
# 標準は縦ベクトルなので、転置して横ベクトルにする
C <- t(C)
R <- 0
# ワルド検定量
(ws <- t(C %*% b - R) %*% solve(C %*% vcov(r_polr) %*% t(C)) %*% (C %*% b - R))
             [,1]
[1,] 0.0009253855
検定統計量が小さいです。
# χ二乗検定
pchisq(ws, length(c_r) - 1, lower.tail = FALSE)
         [,1]
[1,] 0.975732
p値も0.1を遥かに超えます。30代、40代でやっても同様の結果です。なお、有意になっても効果量が女性の場合よりも圧倒的に小さいので、話は変わらないと思います。
平行性の検定
上で推定した順序ロジットは、複数の閾値を推定するモデルの係数が、すべて同一である平行性が仮定されています。しかし、これは必ずしもそうとは限りません。平行性の仮定が疑わしいときはbrant検定で確認します。
library(brant)
brant(r_polr)
--------------------------------------------
Test for	X2	df	probability
--------------------------------------------
Omnibus		16.2	14	0.3
sexmale		0.09	2	0.95
gen30s		0.3	2	0.86
gen40s		1.54	2	0.46
gen50s		0.44	2	0.8
sexmale:gen30s	1.37	2	0.5
sexmale:gen40s	0.53	2	0.77
sexmale:gen50s	0.69	2	0.71
--------------------------------------------
今回は平行性の仮定が棄却されることはありませんでしたが、棄却された場合は一般化順序ロジットモデルの適用を検討すべしとなります。
まとめと注意
この図表の掲載してあったレポートでは、(図表をよくみたら掴めるとは思いますが)女性の方の年代による変化が指摘していなかったので、それをこの分析の成果としましょう。
なお、全体としてどういう分布になっているかを掴むのには図表の方がよく、今回の推定は空目防止ぐらいの効果しかないので、過信は禁物です。
